打開鏈上數據儀表板,活躍地址(Active Addresses)與活躍實體(Active Entities)經常並排呈現。兩者走勢大致同向,數值卻往往相差數倍。初次接觸鏈上分析的使用者容易產生誤解,以為實體數只是地址數的簡單修正。事實上,兩者衡量的是截然不同的對象:活躍地址統計的是底層記帳單位的活動頻次,而活躍實體則試圖還原這些記帳單位背後的真實控制者。
將兩項指標拆解分析,可以清楚看見其定義邊界、數據服務商的計算機制、導致數值差距擴大的核心因素,以及在估值、空投審查、風控與盡調等具體場景中的適用邏輯。理解兩者在復算難度與推斷依賴度上的本質差異,是避免鏈上數據誤讀的基礎。
地址是鏈上最小的記帳單位,但它不攜帶身份
理解指標差異的前提在於認識底層單位的特性。區塊鏈上的地址在比特幣這類 UTXO 模型中代表一組接收條件,在以太坊等帳戶模型中則是一個狀態容器。其共通特徵在於控制權完全取決於私鑰或合約邏輯,協議層完全不包含身份識別資訊,僅記錄「哪個地址在何時完成了何種狀態變更」。
鏈上生成地址的成本極低,單一主體可在數秒內產生大量錢包;與此同時,單一地址(例如中心化交易所的充提熱錢包)也可能同時服務數十萬名使用者。因此,地址計數是客觀的技術指標,若要將其折算為使用者規模,必須引入額外的推斷層,這正是「實體」概念的由來,也是所有估算誤差的根源。
三種常見的地址形態
- 外部帳戶(EOA):由私鑰直接控制,散戶日常錢包與大部分個人交易地址均屬此類。
- 合約帳戶:由代碼邏輯控制,包含去中心化金融(DeFi)協議、多簽金庫及各類智能帳戶。
- 工具型地址:用於批量歸集、找零、中繼轉發或套利機器人的過渡地址,生命週期通常極為短暫。
不同數據分析平台在統計活躍地址時,對合約帳戶與工具型地址的處理方式不盡相同,這也是跨平台比較數據時產生偏差的主要原因之一。
活躍地址:統計口徑的關鍵細節
活躍地址的通用定義是在指定時間窗口內,至少在一筆交易中作為發送方或接收方出現過一次的唯一地址數量。雖然定義簡明,但在實際落地的統計口徑上存在多個需要核實的關鍵維度:
觀察窗口決定數字的量級
日活躍地址(DAA)是最普遍的統計維度,此外還有週活躍(WAU)與月活躍(MAU)。觀察窗口越長,納入計算的唯一地址總量越大。月活躍與日活躍的比值常被用於觀察生態黏性:比值顯著偏高意味著使用者群體分散且單一地址互動頻率低;比值偏低則說明整體網絡主要由一批高頻交互地址支撐。
四個必須確認的口徑細節
- 失敗交易的納入規則:以太坊等公鏈上的失敗交易仍會上鏈並消耗燃料費(Gas),但未產生預期的狀態變更。多數主流數據源(如 Dune 常用查詢、CryptoQuant 等)在常規口徑下偏向僅計算成功交易,以排除機器人重試與無效搶跑造成的數據虛高。
- 內部轉帳(Internal Transactions):透過智能合約調用觸發的價值轉移不顯示於外層交易的發送/接收欄位。將內部轉帳納入統計會顯著拉高 DeFi 高頻互動鏈的活躍地址數。多數平台默認僅以最外層交易發送方與接收方為準。
- 合約地址的篩選:部分統計視角僅計算 EOA 發起方,用以觀察真實發起者的規模;另有平台將被調用的活躍合約地址一併計入,用於反映網絡節點的綜合活躍度。
- UTXO 交易結構的天然放大:比特幣的多輸入多輸出特性會使單筆交易涉及數十個地址。資金歸集與找零過程會在短時間內產生大量關聯地址,進而推高活躍地址讀數。
活躍實體:透過地址聚類還原控制主體
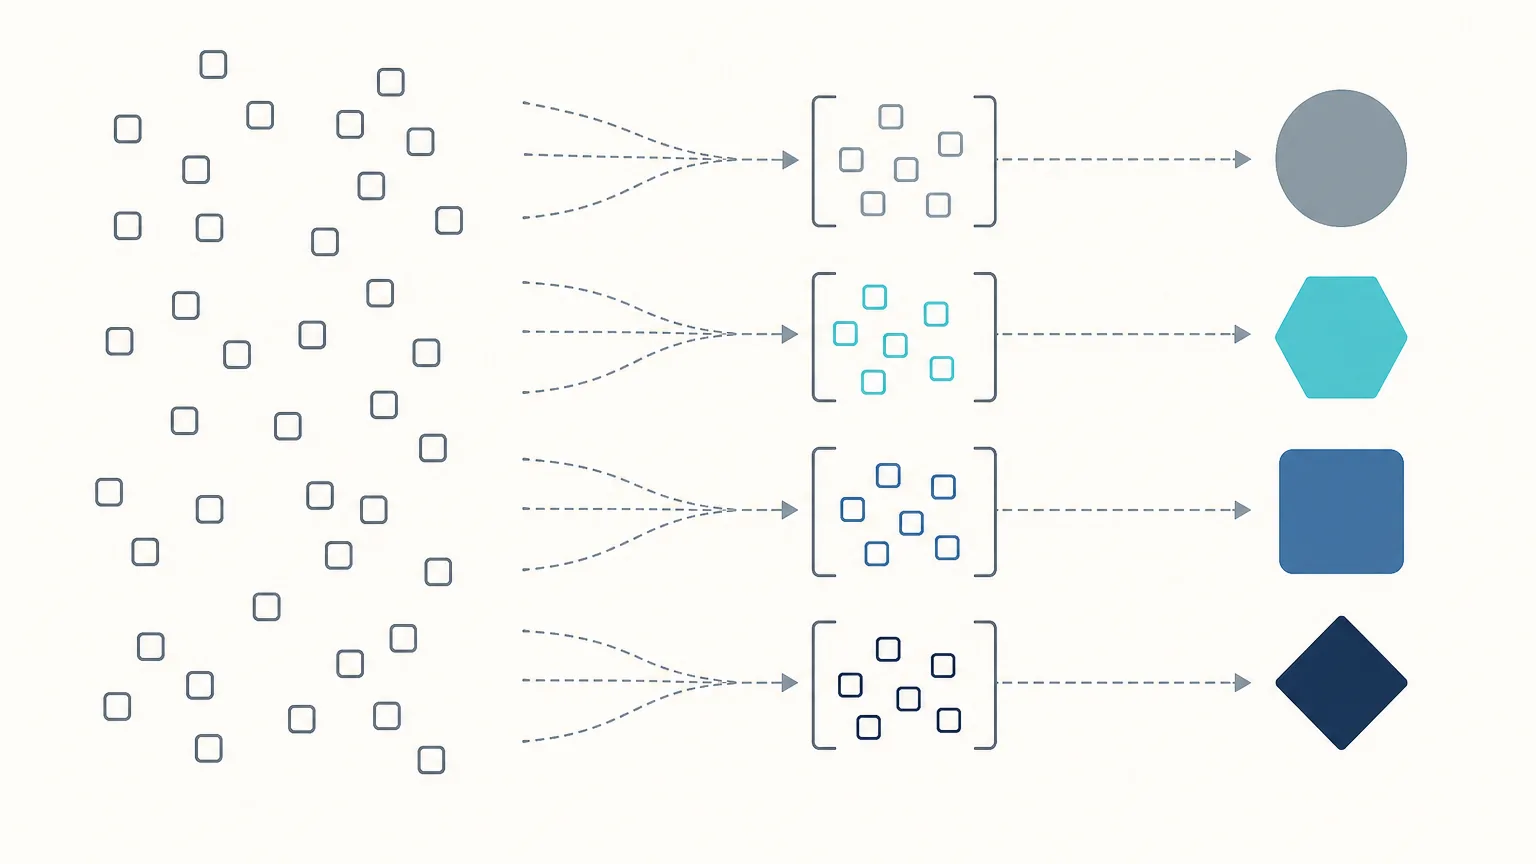
活躍實體(Active Entities)旨在解決多地址關聯問題。鏈上單一控制主體往往同時操作多個錢包,將這些關聯地址歸併後計為單一單位,能更精準地評估生態的真實參與規模。以 Glassnode 的定義體系為例,實體被定義為「經由算法聚類與標籤數據庫確認、由同一控制主體操作的地址集合」。
鏈上聚類的主要技術路徑
聚類算法根據不同區塊鏈架構的特徵提取關聯線索:
- 共同花費啟發式(Common Input Ownership):在比特幣 UTXO 體系中,多個輸入地址若在同一筆交易中被花費,通常表明其由同一私鑰或控制方持有。該啟發式在混幣器或多簽場景中存在失效邊界。
- Gas 支付與資金溯源:在以太坊等帳戶模型中,多個新地址的首筆燃料費若源自同一母地址,常作為強關聯信號。
- 行為特徵指紋:相同的調用路徑、高度一致的交易時間間隔與 Gas 費率設定,均可用作輔助聚類特徵。
- 機構與標籤庫匹配:結合交易所熱錢包、做市商、質押合約、跨鏈橋等已知標籤,將龐大地址群歸類至指定機構實體名下。
實體聚類的內在誤差邊界
活躍實體本質上是推斷性估計值而非精確技術計數。例如:中心化交易所的批量出金可能導致互不相關的接收地址因模式相似被誤歸關聯;混幣協議與隱私工具則會主動打散鏈上足跡,使單一實體被拆解為多個孤立單元。因此,引用實體指標時,必須結合數據源的方法論背景進行評估。
導致活躍地址與活躍實體差距擴大的核心因素
多數情況下活躍地址數顯著高於活躍實體數,兩者比值在以下特定鏈上活動激增時會顯著擴大:
中心化交易所與託管架構
交易所出金與歸集機制每天牽涉龐大地址量。在地址層面,每次交互均計入活躍數;在實體層面,成熟的算法會將交易所附屬錢包與內部流程歸併,因此實體數的波動幅度遠比地址數平緩。
空投預期與批量操作(Sybil 活動)
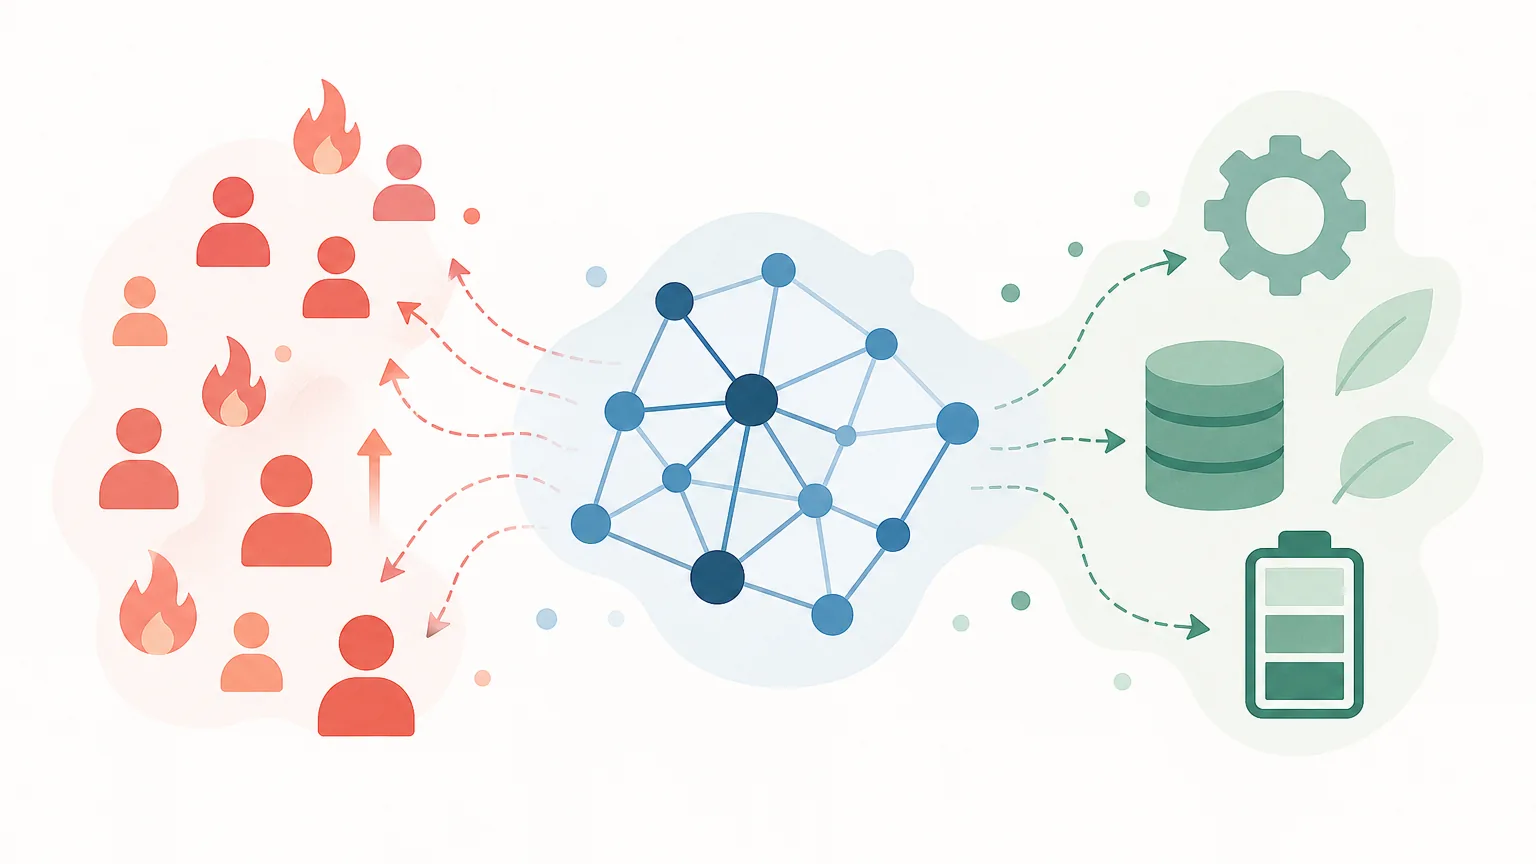
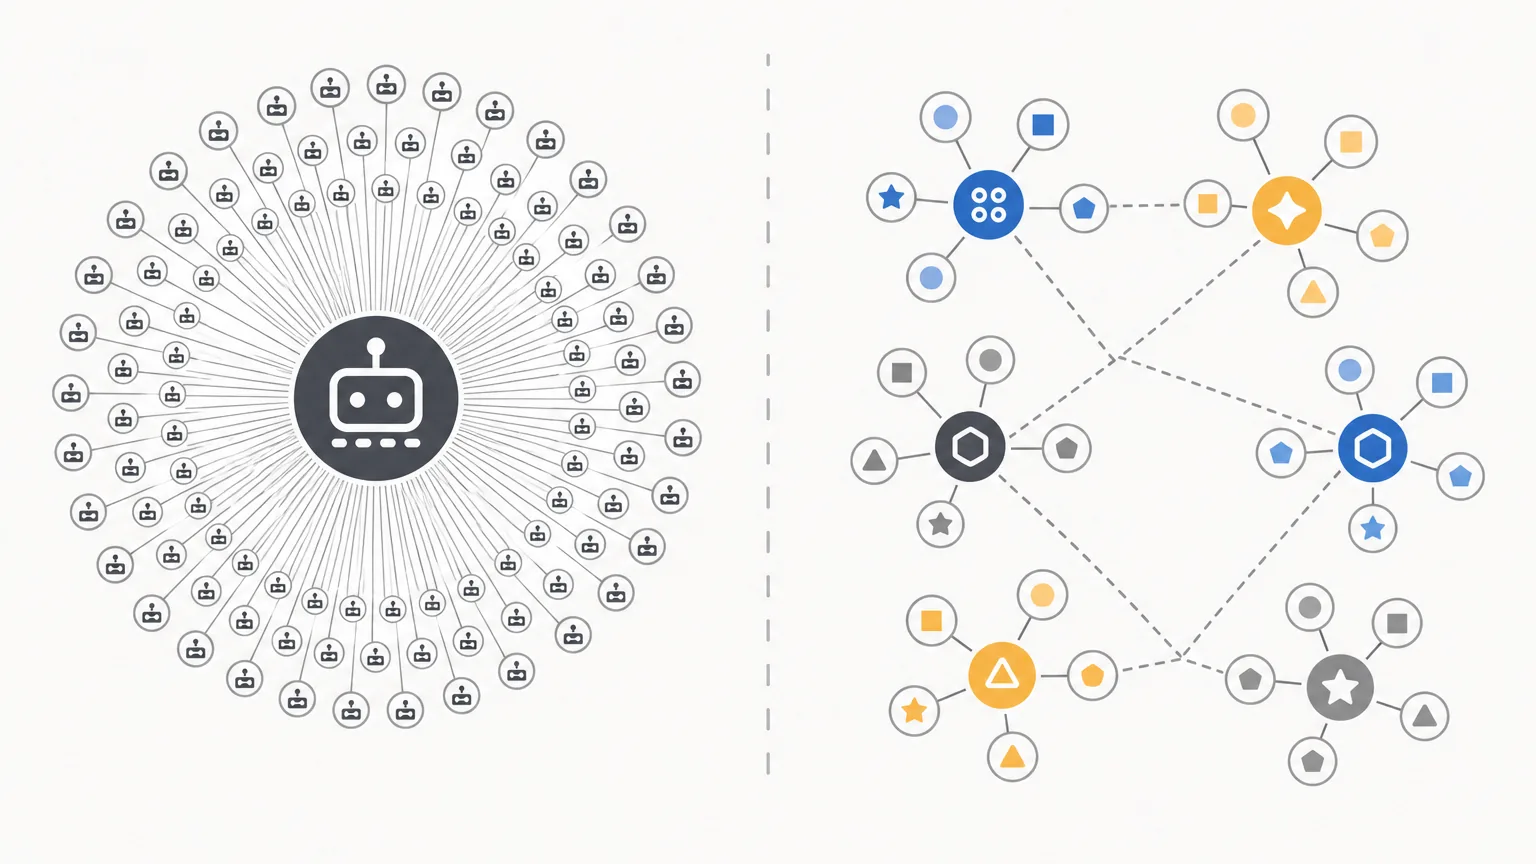
激勵計劃常引發女巫農場(Sybil Farms)的自動化交互,單一團隊可能調用數千個獨立地址執行標準化任務。此時活躍地址會呈現爆發式增長,而活躍實體增長相對有限。
MEV 與自動化做市策略
套利與清算機器人會持續調用短期合約與中間錢包。這些高頻操作推高了網絡吞吐與地址活躍度,但在實體維度上僅對應少數自動化量化機構。
帳戶抽象(ERC-4337)與代付機制
在帳戶抽象架構下,用戶可透過 Paymaster 由第三方代付 Gas,或使用穩定幣等 ERC-20 代幣結算費用。傳統「Gas 支付方即控制者」的啟發式規則在此場景下會出現偏差,若聚類算法未適配該規範,容易將共用同一 Paymaster 的獨立用戶錯誤合併為超大實體。
核心維度對比
| 維度 | 活躍地址(Active Addresses) | 活躍實體(Active Entities) |
|---|---|---|
| 基本定義 | 指定窗口內至少參與一筆交易的唯一地址 | 經算法聚類與去重後的唯一控制主體集合 |
| 計算基礎 | 區塊頭及交易列表直接計數 | 依賴啟發式聚類規則、圖算法與標籤庫 |
| 推斷依賴度 | 無推斷,結果確定性高 | 高度依賴數據服務商的模型與算法更新 |
| 抗噪音能力 | 較弱,極易受刷量、機器人與空投干擾 | 較強,能有效過濾部分批量操作與內部劃轉 |
| 跨平台一致性 | 高(在對齊過濾口徑的前提下) | 較低,各服務商標籤庫與聚類模型存在差異 |
| 核心適用場景 | 網絡負載監控、Gas 消耗分析、吞吐評估 | 基本面估值、真實用戶增長審查、反女巫風控 |
實務應用場景解析
估值模型構建
梅特卡夫定律(Metcalfe’s Law)常將網絡價值與活躍使用者規模關聯。若直接採用易受操縱的活躍地址作為自變量,在空投激勵期容易得出過度高估的結論。將活躍地址與活躍實體的比值(Addresses per Entity)納入監測,當該比值異常拉升而實體數停滯時,通常預示增長由短期套利或批量操作主導。
空投審查與反女巫(Anti-Sybil)
項目方針對空投資格的篩查實質上是實體聚類技術的實踐應用。透過識別關聯資金源、合約調用時間序列及 Gas 行為特徵,項目方將散落的交互地址還原為單一女巫集群並予以標記。
項目盡調與資金審計
機構在評估新公鏈或協議生態時,單純依賴地址計數易被虛假繁榮誤導。結合活躍實體數量、新增實體的資金留存率以及大額持倉實體的分佈情況,能更客觀地還原生態的健康程度與資金集中度。
常見問答(FAQ)
Q1:為什麼各個數據平台的活躍地址數經常對不上?
主要源於四項統計口徑的差異:統計窗口時區設定、是否計入執行失敗交易、是否過濾合約帳戶互動,以及是否包含合約內部轉帳。在對比數據前,必須先核對平台指標說明文件。
Q2:活躍實體數是否一定比活躍地址更準確?
活躍實體更貼近「獨立使用者」的概念,但其本質是依賴算法估算的統計值,並非精確的技術記錄。在評估手續費負載、網絡吞吐等純客觀技術狀態時,直接可復算的活躍地址指標反而更為乾淨。
Q3:如何在 Dune 或區塊瀏覽器中自行估算活躍實體?
在無現成標籤庫的情況下,可透過 SQL 查詢建立基礎啟發式過濾:例如按共同轉入資金源(First Funding Source)歸集地址、排除已知交易所熱錢包交互、或過濾同一區塊內調用行為高度一致的交易群,以構建粗略的實體層數據。