打開任何一張硬體加速卡的規格表,常會看到一整欄數值:TFLOPS、TOPS、GB/s、W。它們被印在同一個欄位中,看似代表相同維度的運算能力,但背後對應的測量條件截然不同——有的預設運算單元百分之百滿載,有的僅在特定稀疏架構下成立,有的則綁定極窄的數值精度。單純把這些數字拿來橫向對比,是進行硬體選型與架構規劃時極具風險的做法。
評估各類算力指標已成為企業採購、模型研發與雲端架構部署的標準流程。無論是預估集群規模、評估既有設備能否承載新一代模型,或是在繁雜的雲端實例規格中做取捨,理解規格背後的工程邊界,能幫助決策者在預算分配與效能調優時掌握主動權。
算力指標為什麼值得深入掌握
算力指標是工程團隊、研究人員與採購部門之間的共通語言。然而,在商務簡報或宣傳品中,晶片能力往往被簡化為單一的峰值數字,且多半取自最理想的測試條件。
清楚拆解這些指標,有助於精確判斷宣傳數值在目標負載下的落地比率;能夠推估大型模型訓練所需的節點規模與耗時;並在推論服務中釐清效能瓶頸究竟源於矩陣運算還是記憶體搬運。更重要的是,在面對各類報價單與架構方案時,團隊能直擊記憶體頻寬與網路互連等關鍵限制,避免硬體部署後實測吞吐大幅落後預期的困境。
最底層的度量標準:FLOPS 體系
FLOPS(Floating-point Operations Per Second,每秒浮點運算次數)是衡量浮點計算能力的核心標準。深度學習的主體為矩陣乘法,由密集的乘加運算(Fused Multiply-Add, FMA)構成。在硬體層面,一次 FMA 通常計為兩次浮點運算(一次乘法與一次加法)。晶片廠商標註的理論峰值算力公式通常為:時脈頻率 × 運算單元總數 × 每週期 FMA 數 × 2。此公式成立於所有單元全時滿載、管線無氣泡且資料零延遲供給的極限假設下。
量級單位由 kFLOPS、MFLOPS、GFLOPS 遞增至 TFLOPS(每秒 10¹² 次)、PFLOPS(每秒 10¹⁵ 次) 與 EFLOPS(每秒 10¹⁸ 次),每級跨越一千倍量級差。檢視規格時,確認數值單位的數量級與所對應的數值精度,是建立客觀評估的第一步。
TOPS:整數運算的衡量體系
TOPS(Tera Operations Per Second,每秒兆次運算)主要用於衡量整數(如 INT8、INT4)或混合精度場景,廣泛應用於邊緣運算 NPU、車載系統與行動端晶片。整數運算單元在晶片晶粒面積與能耗控制上具備顯著優勢,因此在功耗受限環境中,TOPS 與每瓦效能(TOPS/W)是更為關鍵的參考標準。各家晶片對單次運算的計算口徑(如是否包含乘加合併)可能存在差異,跨架構比對時需參照原廠指令集定義。
數值精度對算力天花板的影響
同款晶片在不同精度下的理論吞吐可差距數倍乃至數十倍。處理 64 位元雙精度浮點數所需的電路面積與功耗,遠高於 8 位元或 4 位元資料型態。當前大型語言模型(LLM)訓練主要採用 BF16 或 FP8 混合精度策略;推論端則普遍導入 INT8、INT4 甚至 FP4 量化技術;而在科學計算與工程模擬領域,對數值穩定性要求嚴苛,FP64 仍是無法替代的剛性需求。
(可左右滑動檢視完整表格內容)
| 數值格式 | 位元結構與動態範圍特徵 | 主要應用場景 |
|---|---|---|
| FP64 | IEEE 754 雙精度,數值動態範圍與精度最高,記憶體與能耗開銷大 | 科學計算、氣候模擬、量子化學、物理仿真 |
| FP32 | IEEE 754 單精度,傳統深度學習基準數值格式 | 中小模型訓練、通用計算、高精度推論 |
| TF32 | 保留 FP32 指數動態範圍(8 位元),尾數精度縮減至 10 位元 | 深度學習張量矩陣乘法硬體加速,免調程式碼直接替代 FP32 |
| BF16 | 指數範圍與 FP32 一致(8 位元),尾數為 7 位元,抗溢位能力強 | 當前大型語言模型(LLM)預訓練與微調主流格式 |
| FP16 | IEEE 754 半精度,尾數精度高於 BF16 但指數範圍較窄,易下溢 | 傳統混合精度訓練、視覺模型與高效推論 |
| FP8 (E4M3 / E5M2) | 分為重視精度的 E4M3 與重視動態範圍的 E5M2,需搭配動態縮放 | 新一代大型模型高效訓練與主流推論吞吐加速 |
| INT8 / INT4 | 定點整數,運算效率高、記憶體佔用極低,需配合量化校準 | 雲端高併發推論部署、邊緣端設備即時運行 |
稠密與稀疏運算架構差異
在最新硬體架構中,規格表常列出「稠密(Dense)」與「稀疏(Sparse)」兩組算力數據,後者通常為前者的兩倍。例如 NVIDIA 在 Ampere 及後續架構中引進的 2:4 結構化稀疏技術,要求每連續四個權重中有兩個為零值,硬體單元透過跳過零值乘加運算,使理論運算吞吐量實現翻倍(參考 NVIDIA Ampere Architecture Whitepaper)。
然而在實際工程中,稀疏加速要求模型在剪枝後維持足夠精度,且底層軟體堆疊需完整支援相關算子。對於注意力機制(Attention)、正規化(LayerNorm)或部分非線性激活層,結構化稀疏往往無法全覆蓋。在進行叢集容量規劃時,以稠密算力作為基準底線能提供更高的穩定性與容錯空間。
峰值算力與實際有效效能的落差
理論峰值代表硬體在無任何干擾下的理論極限。在實際工作負載中,記憶體資料載入延遲、算子矩陣維度不匹配、多核心同步屏障以及跨節點通訊等待,都會使硬體處於不同程度的閒置狀態。
MFU:衡量實際運算轉化率
MFU(Model FLOPs Utilization,模型浮點利用率)是用於衡量模型在硬體上實際達成運算效率的核心指標。其定義為:模型前向與反向傳播在理論上所需的浮點運算總量,除以單步實際執行耗時,再除以硬體的理論峰值算力。
在 Google 關於大型語言模型的標竿研究中(參考 PaLM: Scaling Language Modeling with Pathways, arXiv:2204.02311),PaLM 540B 在 6144 顆 TPU v4 晶片的大規模訓練集群上,所達成的 MFU 實測值約為 46.2%。這代表在頂級工程調優與專用架構下,實際用於模型訓練的有效算力約佔硬體理論峰值的一半左右。在常規分散式叢集中,受限於模型切分策略與網路拓撲,MFU 通常落在 30% 至 45% 區間。因此,在規劃訓練時間與硬體規模時,將 MFU 係數納入考量是確保時程精準的必要步驟。
提示:在推算模型訓練週期時,切勿直接以理論峰值進行除法估算。務必結合並行策略,帶入 35%~45% 的 MFU 係數進行折算,方能取得具備工程參考價值的耗時與成本預估。
標準基準測試的參考價值
業界公開的基準測試(如 MLCommons 組織主導的 MLPerf)為評估跨硬體平台提供了標準化環境。這些測試覆蓋語言生成、影像辨識、推薦系統等典型負載。解讀數據時需注意:公開榜單成績多來自廠商專屬深度調優的環境,在批次大小(Batch Size)與算子編譯上進行了客製優化。在選型最終階段,將目標模型移入候選架構進行端到端(End-to-End)壓測,是驗證吞吐量、延遲與顯存消耗的最可靠方式。
記憶體子系統:決定效能釋放的關鍵要素
隨著計算核心處理速度的指數級提升,記憶體傳輸速度的增長相對平緩,這形成了運算架構中長期的「記憶體牆(Memory Wall)」挑戰。在多數深度學習與大型模型推論場景中,制約整體吞吐的瓶頸往往不是算力本身,而是資料在晶片與記憶體之間的搬運頻寬。
記憶體容量與頻寬的分工
記憶體容量決定了單張晶片或單個節點所能承載的資料總量。訓練階段需要同時容納模型權重、梯度、優化器狀態(如 Adam 狀態佔用往往達到權重數倍)及前向傳播的中間激活值;在推論階段,顯存空間主要由模型權重及隨上下文長度與併發數線性增長的 KV Cache 所佔據。
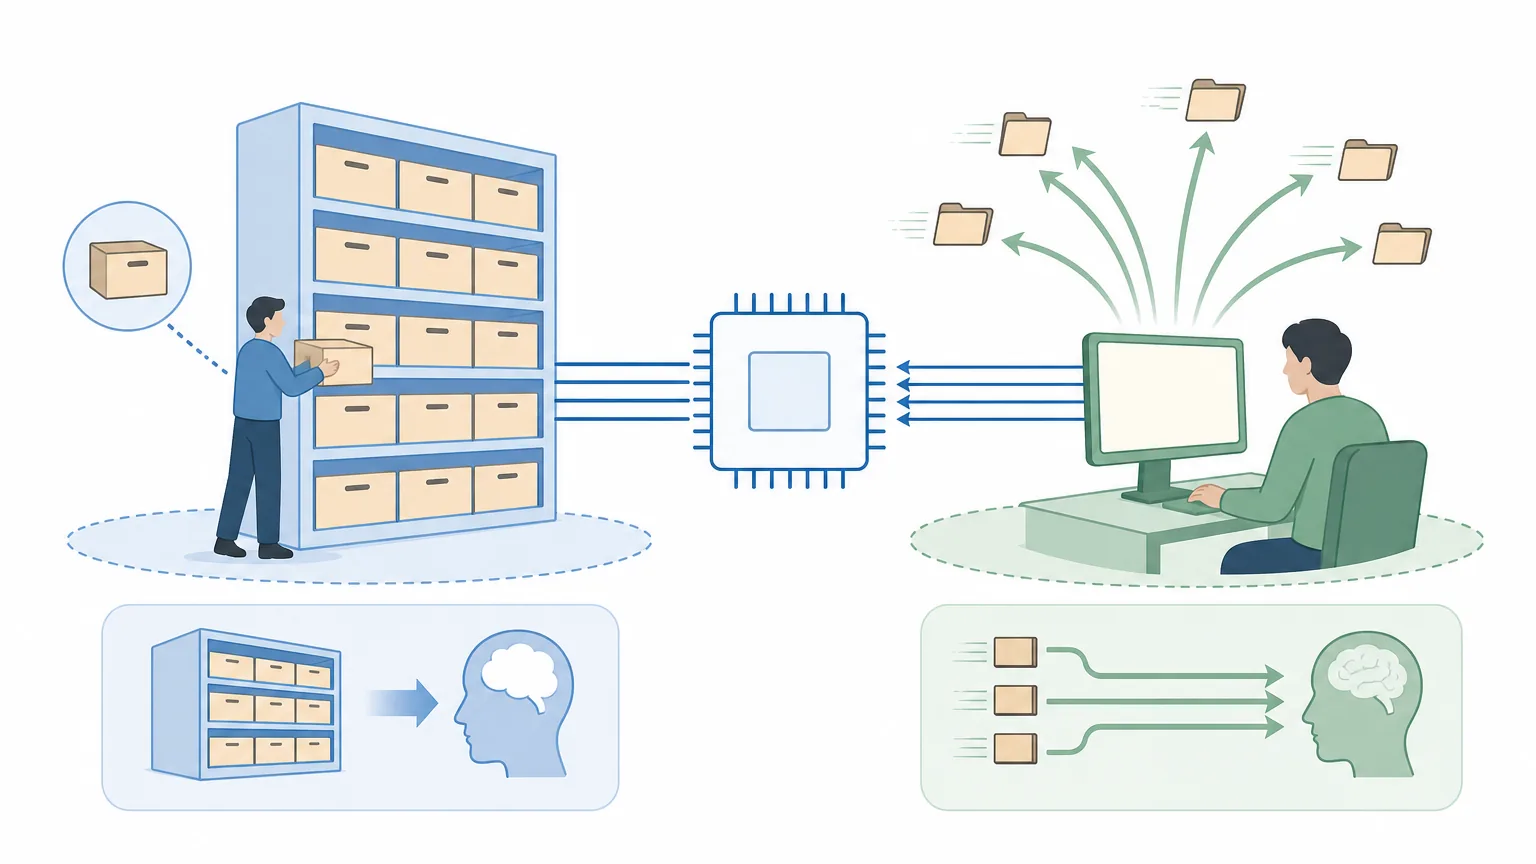
記憶體頻寬(如 HBM3、HBM3e 提供的數 TB/s 傳輸率)則決定了資料搬運的速率。在激活函數、LayerNorm、Softmax 等低運算強度算子中,硬體每搬運一個位元組僅執行極少次運算,記憶體頻寬的高低直接決定了計算單元是否會長時間處於飢餓狀態。
Roofline 模型與算力頻寬比
判斷效能瓶頸的標準工具是 Samuel Williams 等人提出的 Roofline 效能模型(參考 ACM Communications: Roofline: An Insightful Visual Performance Model)。該模型定義了運算強度(Operational Intensity),即每從記憶體讀寫 1 個位元組(Byte)所能執行的浮點運算次數(FLOPs/Byte)。
硬體的「屋脊轉折點」由理論峰值算力 ÷ 峰值記憶體頻寬決定。若演算法的運算強度高於轉折點,系統屬於「運算受限(Compute-Bound)」,增加算力可直接提升效能;若運算強度低於轉折點,系統則處於「記憶體受限(Memory-Bound)」,此時盲目堆疊算力毫無助益,必須透過算子融合(Operator Fusion)、減少資料往返或升級記憶體頻寬來解除瓶頸。
(可左右滑動檢視完整表格內容)
| 系統監控觀察現象 | 核心效能瓶頸歸屬 | 工程調優方向 |
|---|---|---|
| 調大 Batch Size 後單步吞吐幾乎無提升 | 記憶體頻寬瓶頸 | 實施算子融合(如 FlashAttention)、優化資料重用、遷移至高頻寬記憶體(HBM)平台 |
| 調大 Batch Size 後計算單元利用率與吞吐顯著線性上升 | 運算核心未飽和 | 合理提升批次規模與序列長度,充分填滿張量核心(Tensor Cores)管線 |
| 擴展卡數後叢集加速比顯著低於線性預期 | 節點間通訊瓶頸 | 調整並行策略(流水線/張量/專家並行切分)、升級 RDMA 網路頻寬、優化拓撲路由 |
| GPU/加速卡核心利用率呈現週期性大幅下探 | 資料管線或儲存 I/O 阻塞 | 排查資料讀取預取佇列(DataLoader)、啟用記憶體映射與高效分散式儲存快取 |
互連架構與資料管線:規模化集群的生命線
單卡效能優異並不保證集群規模擴展時能維持線性成長。當模型分散至數十至數萬顆晶片運行時,節點內部與跨節點的通訊傳輸效率,往往成為決定集群實際擴展效率的關鍵。
節點內部互連
在單一伺服器節點內,加速卡通常依託專屬高頻寬通道(如 NVLink)或 PCIe 匯流排互連。專屬互連具備雙向數百 GB/s 的極高頻寬與點對點記憶體直接存取(DMA)特性,這對於張量並行(Tensor Parallelism)至關重要,因為該策略需要在每一層前向與反向計算中進行密集的 All-Reduce 通訊。八卡全互連架構與非對稱分組拓撲在承載高強度並行負載時,會展現出顯著的延遲差異。
節點間叢集網路
跨節點擴展需依賴高效能網路架構,常見方案包含 InfiniBand 與 RoCEv2(基於聚合乙太網的 RDMA)。在純資料並行下,梯度同步通訊量主要與模型參數量相關;但當進入管線並行(Pipeline Parallelism)與專家並行(MoE 混合專家系統中的 All-to-All 交換)時,網路延遲與交換機二層/三層無阻塞轉發能力將直接左右效能表現。
在叢集通訊評估中,可透過估算單步迭代中的總通訊位元組數與可用實測頻寬,計算通訊等待時間佔比。在實際工程經驗中,當通訊耗時佔比顯著上升時,擴展效率將面臨拐點,需依據具體網路拓撲動態調整模型切分與通訊重疊(Overlap)策略。
儲存 I/O 與 Checkpoint 機制
分散式儲存的讀寫頻寬與 IOPS 表現同樣不可忽視。在訓練啟動與資料加載階段,若資料前處理與磁碟讀取無法跟上矩陣計算速率,計算單元將陷入頻繁等待。此外,超大模型的檢查點(Checkpoint)儲存容量常達數百 GB 至數 TB,若儲存寫入頻寬受限,每次存檔將迫使整體叢集處於長時間同步停頓,從而壓低整體集群的長期有效作業率。
能效指標與總持有成本(TCO)
運算系統的運行伴隨著電能消耗與熱量耗散。在大型資料中心與集群營運中,功耗密度與冷卻能力直接構成了機櫃空間的物理上限。
每瓦算力與 PUE 指標
FLOPS/W 與 TOPS/W 用於量化單位電能所能轉換的計算能力,在邊緣裝置與高密度算力中心皆是首要評估項。單卡 TDP(熱設計功耗)決定了單機櫃可容納的設備密度。
在資料中心維度,PUE(Power Usage Effectiveness,電力使用效率)用於衡量資料中心總能耗與 IT 設備能耗的比值。根據 Google 官方在資料中心能效說明中的概念展示(參考 Google Data Centers: Efficiency),以 PUE = 2.0 作為教學示意時,代表每消耗 1 瓦的 IT 電力,需額外消耗 1 瓦用於散熱與電力轉換損耗;而在高能效的現代綠色資料中心中,PUE 通常被嚴格優化至 1.1~1.2 區間。PUE 越接近 1.0,非計算能耗佔比越低,長期電費成本結構越為健康。
全面評估 TCO
評估算力基礎設施的成本時,需將伺服器採購成本(CapEx)、機房租賃、電力配額、散熱改裝、高速交換機佈建及運維人力(OpEx)整合納入 3 至 5 年的生命週期模型。以每單位有效算力的總擁有成本(TCO per Effective FLOP)進行決策,能有效避免選用單卡報價便宜但功耗高、軟體維護成本昂貴的潛在風險方案。
軟體生態在算力釋放中的權重
硬體規格僅代表潛力上限,底層軟體堆疊的成熟度直接決定了該潛力能被發揮出幾成。編譯器最佳化、專屬算子庫覆蓋率、主流分散式框架(如 PyTorch、Megatron-LM、vLLM)的整合程度,是影響開發週期與實際吞吐的關鍵變數。
評估硬體平台時,需考察關鍵演算法算子(如各類 Attention 變體、FlashInfer 等)是否具備經調優的高效實現。缺乏完善軟體棧支援的硬體,往往需要額外投入高昂的底層算子客製化開發成本,甚至因生態相容性問題延宕專案交付進度。
不同業務場景的指標關注權重
不同運算負載對各維度指標的敏感度存在顯著差異,針對具體場景需建立客製化的評估側重點:
- 大型語言模型訓練:首要關注 BF16 / FP8 稠密算力、單卡記憶體容量(容量越大容納的激活值與優化器狀態越多)、節點內部超高頻寬專用互連(支援張量並行)及節點間低延遲 RDMA 網路。FP64 算力在此場景下基本不具影響力。
- 大模型線上推論與 Serving:重點關注 記憶體頻寬(決定自回歸解碼輸出 Token 的延遲上限)、記憶體容量(決定 KV Cache 支援的最大併發連線數)、INT8 / INT4 / FP8 吞吐效能,以及首字延遲(TTFT)與後續字元生成速率(TPOT)。
- 推薦系統與搜尋排序:此類模型具備龐大的 Embedding 查找表,屬於高隨機存取的記憶體密集型負載,核心指標聚焦於記憶體容量、隨機存取頻寬與稀疏算子處理效能。
- 科學計算與物理仿真:高度依賴數值精確度與無誤差積累,FP64 雙精度算力、ECC 記憶體錯誤糾正、數值重現性與記憶體頻寬是決定架構可用的首要指標。
- 邊緣智慧與終端設備:受限於空間、被動散熱與電池續航,TOPS/W 能效比、INT8 定點推論延遲與休眠功耗為絕對核心維度。
算力規格檢核清單
在審視硬體規格書或雲端算力合約時,建議依循以下七個檢核步驟進行核驗:
- 確認算力數值所對應的數值精度(FP64/FP32/TF32/BF16/FP8/INT8),並確認是否預設了結構化稀疏。
- 檢驗記憶體配置,分別核對顯存容量(GB)與記憶體頻寬(TB/s)是否匹配演算法的運算強度。
- 確認單機內部互連通道技術與雙向頻寬,並確認叢集跨節點網路架構(如 RoCEv2/InfiniBand 頻寬規格)。
- 評估單卡與整機的熱設計功耗(TDP),核對機房供電配額與散熱冷卻能力。
- 核查底層軟體堆疊對主流深度學習框架與關鍵加速算子的官方支援成熟度。
- 參考同類型模型在該架構上的公開實測資料,以預期的 MFU 區間 取代理論峰值進行容量回推。
- 綜合機房能耗、PUE 係數、採購攤提與維護成本,計算每單位有效工作量的全週期總擁有成本(TCO)。
常見誤區與觀念釐清
在算力規劃與實務決策中,以下四個誤區最容易導致資源錯配:
- 混淆稀疏峰值與稠密性能:直接拿稀疏條件下的翻倍理論數字進行訓練排程估算,忽略了模型架構與剪枝策略在未經專案驗證時無法完整發揮稀疏加速的現實。
- 跨精度數值直接對比:將低精度(如 FP8/INT8)算力與高精度(如 FP32/FP64)算力混為一談,忽視了不同任務對數值動態範圍與下溢容忍度的硬性要求。
- 重算力而輕視記憶體與互連:只關注 TFLOPS 大小,未評估記憶體頻寬與節點通訊能力,導致大規模部署後計算核心因等待資料搬運而處於低負載狀態。
- 誤把理論峰值當作開箱即得吞吐:未將軟體編譯調優、分散式通訊開銷與 MFU 折損計入專案週期,導致交付進度落後於理論預期。
常見問題(FAQ)
Q1:為什麼大語言模型訓練普遍轉向 BF16 與 FP8,而不是傳統的 FP32 或 FP16?
A1:BF16 具備與 FP32 完全相同的 8 位元指數範圍,能有效防止梯度計算中的數值下溢與溢位,且顯存佔用直接減半;而 FP8 則進一步壓縮傳輸資料量並激發張量核心的極限吞吐。相較之下,FP16 指數範圍較窄,在大模型訓練時極易發生動態範圍溢出,需要複雜的動態損失縮放(Loss Scaling)機制。
Q2:在規劃大語言模型推論服務時,該如何評估需要幾張加速卡?
A2:需同步計算「權重顯存需求」與「KV Cache 顯存需求」。首先依模型參數量與量化精度(如 70B 模型在 FP16 下約需 140GB,INT4 下約需 35GB)確保權重能完整載入;接著依目標最大併發數與最大上下文長度(Context Length)預估 KV Cache 的空間開銷。若總需求超過單卡顯存容量,則需透過張量並行(TP)或管線並行(PP)將模型切分部署至多張卡上。
Q3:如何快速確認既有的訓練任務是否受到記憶體頻寬限制?
A3:可運用 Roofline 模型的概念進行實驗測試。嘗試在顯存未爆滿的前提下調大 Batch Size,若發現單步耗時幾乎等比例上升、整體 Token 處理吞吐量停滯不前,且 GPU 核心利用率偏低,多半代表系統正處於記憶體頻寬受限狀態;反之若吞吐量隨 Batch 增加而顯著提升,則代表計算單元先前尚未被充分填滿。
Q4:MFU 與常規硬體監控工具(如 nvidia-smi)顯示的 GPU Utilization 有何不同?
A4:nvidia-smi 顯示的利用率僅代表在取樣時間窗口內,是否有任何核心正在執行指令(哪怕核心正在等待記憶體資料讀取),因此經常出現監控顯示 100% 但實際計算效率低下的現象。而 MFU 則是基於演算法理論 FLOPs 進行端到端硬數學推導,精確反映硬體理論峰值算力中真正轉化為有效矩陣計算的百分比。
技術文獻與資料核驗依據(核驗基準:2026-05-09):
- Google PaLM 訓練架構與 MFU 基準報告:PaLM: Scaling Language Modeling with Pathways (arXiv:2204.02311)
- NVIDIA Ampere 架構與 2:4 結構化稀疏技術規範:NVIDIA Ampere Architecture Whitepaper
- Roofline 效能模型理論架構:Roofline: An Insightful Visual Performance Model for Multicore Architectures (CACM, 2009)
- 資料中心能源使用效率(PUE)定義與能效評估:Google Data Centers Efficiency Guide
- 浮點數運算標準:IEEE Standard for Floating-Point Arithmetic (IEEE 754-2019)